Van rapport naar spreadsheet
Bodemrapporten bevatten meetwaarden, tabellen en technische context die samen gelezen moeten worden. Medewerkers van Grondbeheer Genk besteedden daar uren aan. Naast het bestuderen van de documenten moesten ze gegevens overnemen en formules in Excel uitwerken. Bij een uitgebreid rapport kon dat proces tot een halve dag in beslag nemen.
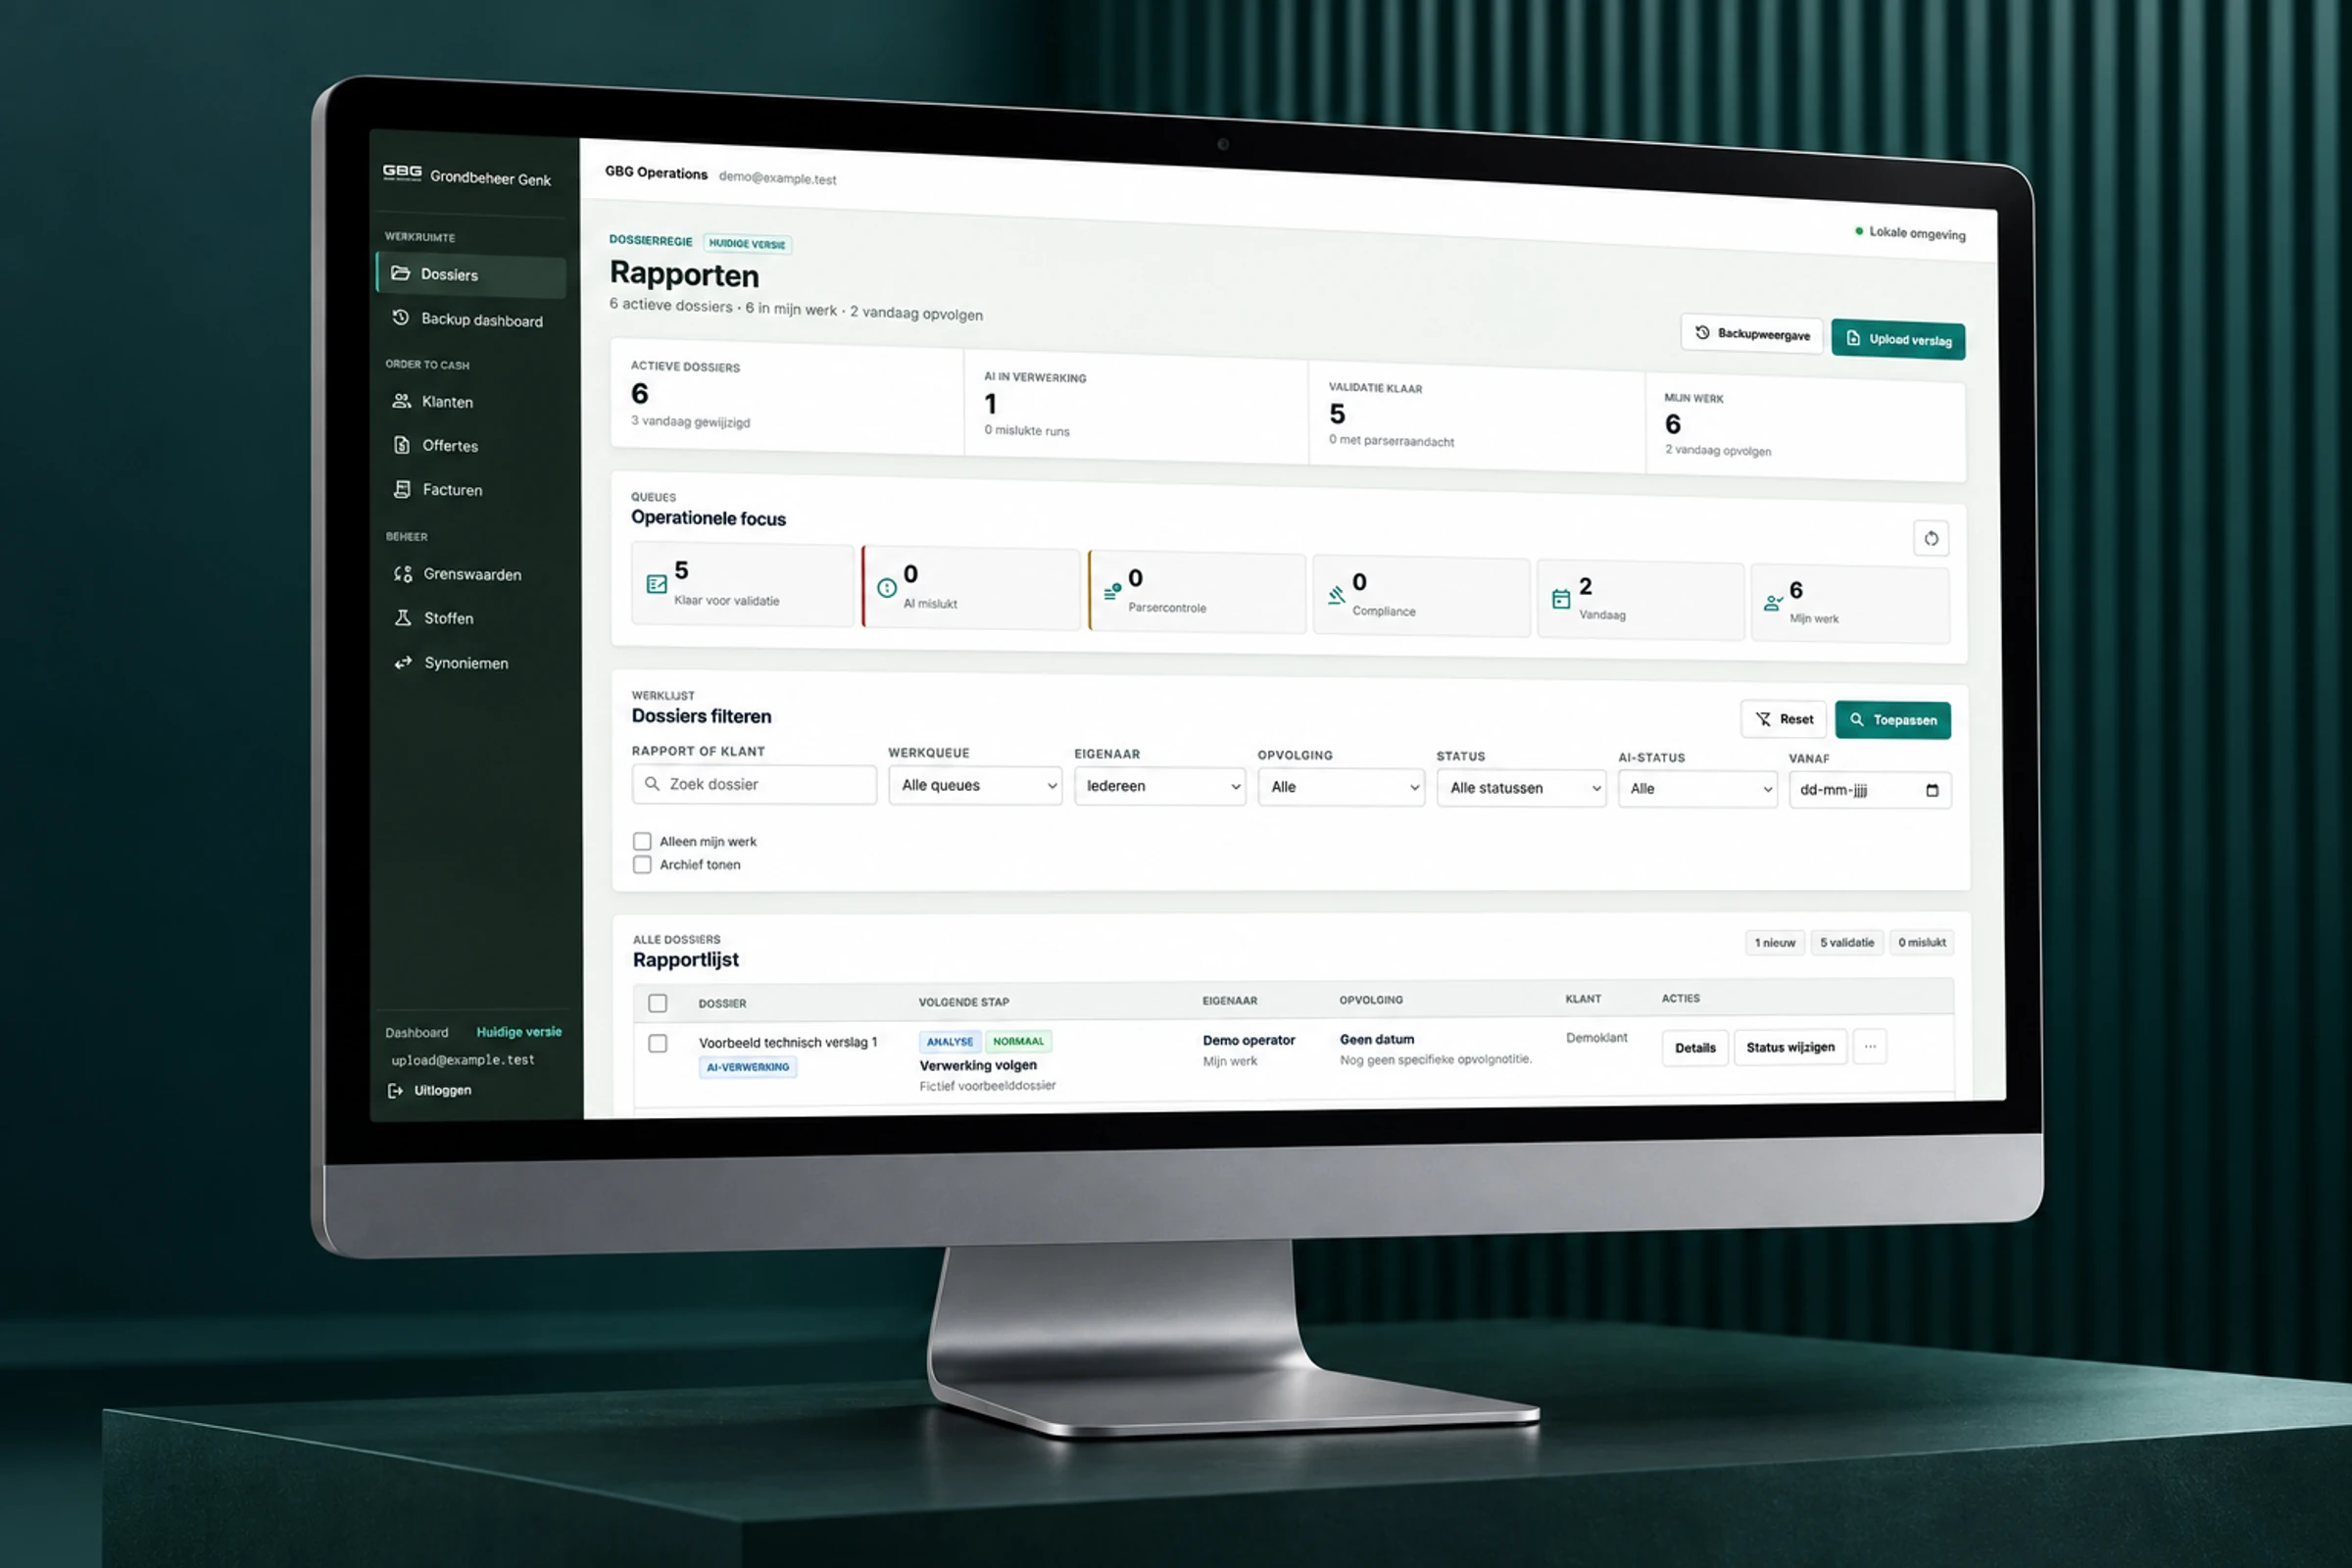
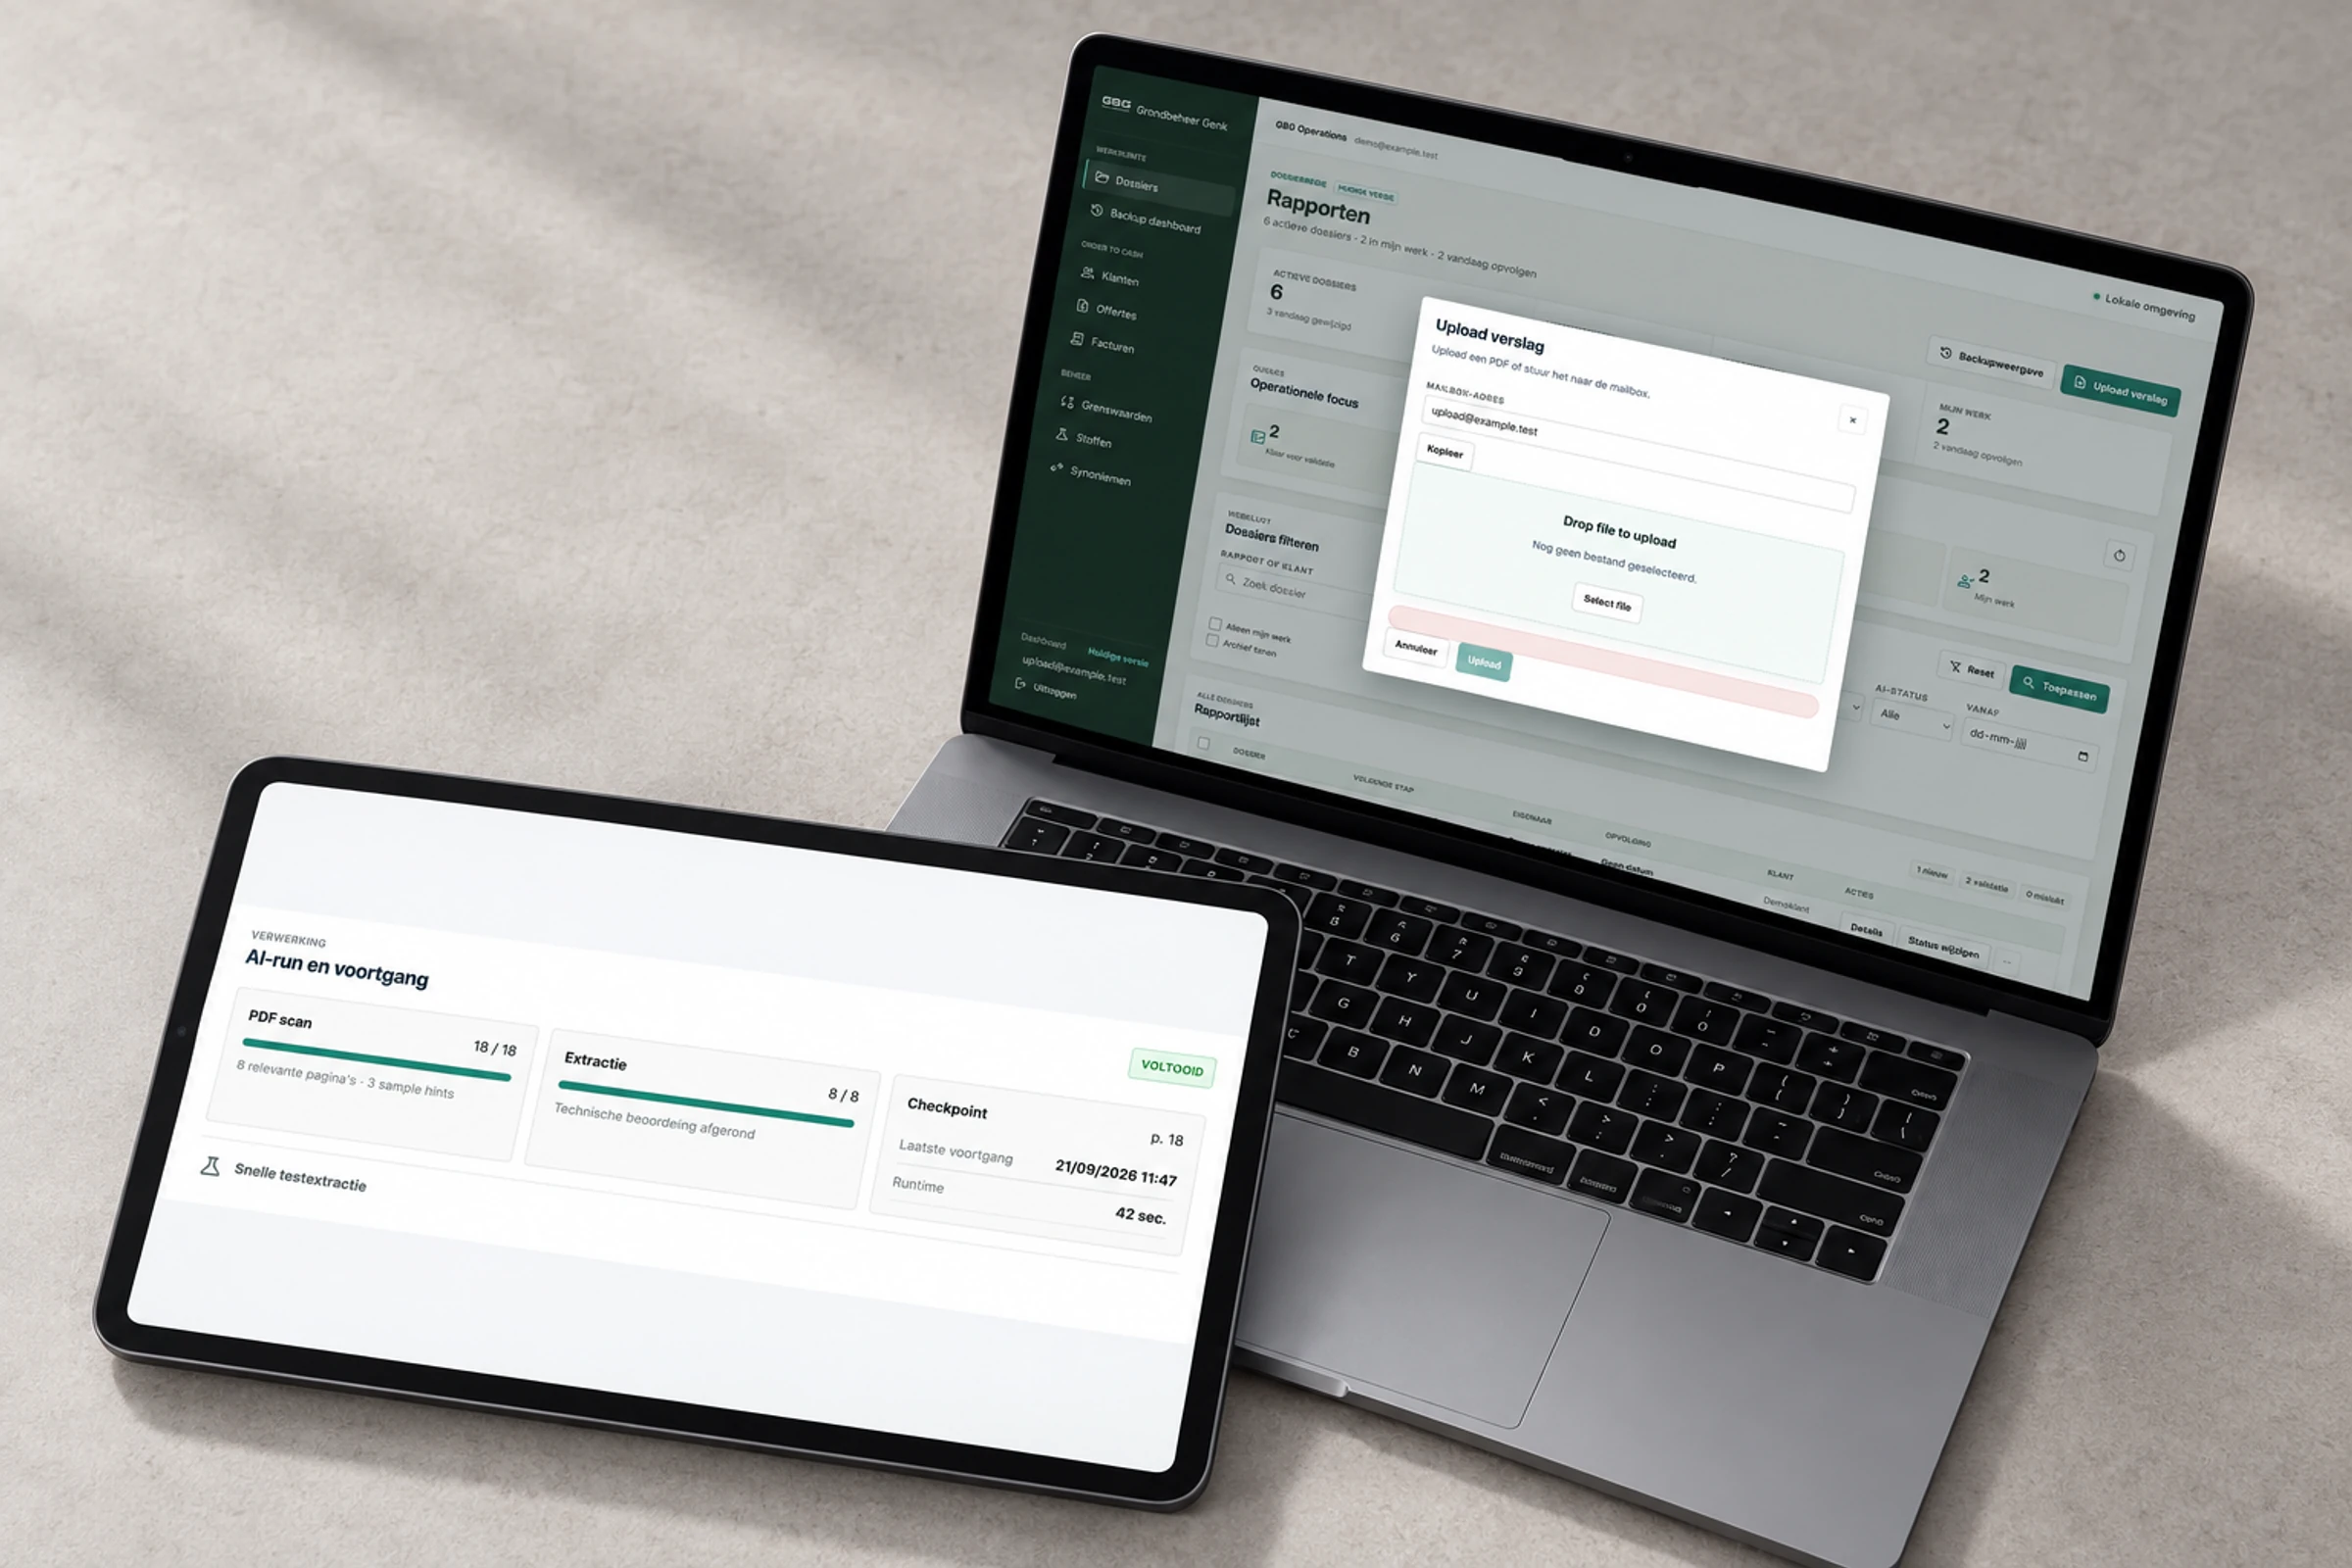
We vertaalden die werkwijze naar een platform dat het terugkerende lees-, extractie- en rekenwerk automatiseert. De medewerker start de verwerking met een upload en kan de resultaten vervolgens binnen hetzelfde dossier controleren.
Meerdere AI-taken met een eigen rol
De backend is gebouwd in Python en Django. Na de upload wordt de PDF onderzocht op relevante pagina's, tabellen en monsteridentificaties. Pagina's krijgen een rol, zoals analyseblad, monsteroverzicht of ondersteunende context. Daardoor kan de verwerking gericht omgaan met de verschillende onderdelen van een rapport.
De AI-pijplijn verdeelt het werk over opeenvolgende taken. Een eerste stap herkent monsters en hun context. Een volgende stap haalt de bijbehorende meetgegevens uit de relevante pagina's. Snellere modellen kunnen de voorbereidende herkenning uitvoeren, terwijl een uitgebreider model voor de data-extractie wordt ingezet. Achtergrondworkers verwerken de taken buiten het normale webverzoek.
Het systeem combineert AI met vaste controles op de documentstructuur. Een monsterregister houdt identificaties over meerdere pagina's bij. Dat helpt om een meetwaarde aan het juiste monster te koppelen wanneer informatie verspreid staat over een rapport.
Van uitgelezen waarden naar berekeningen
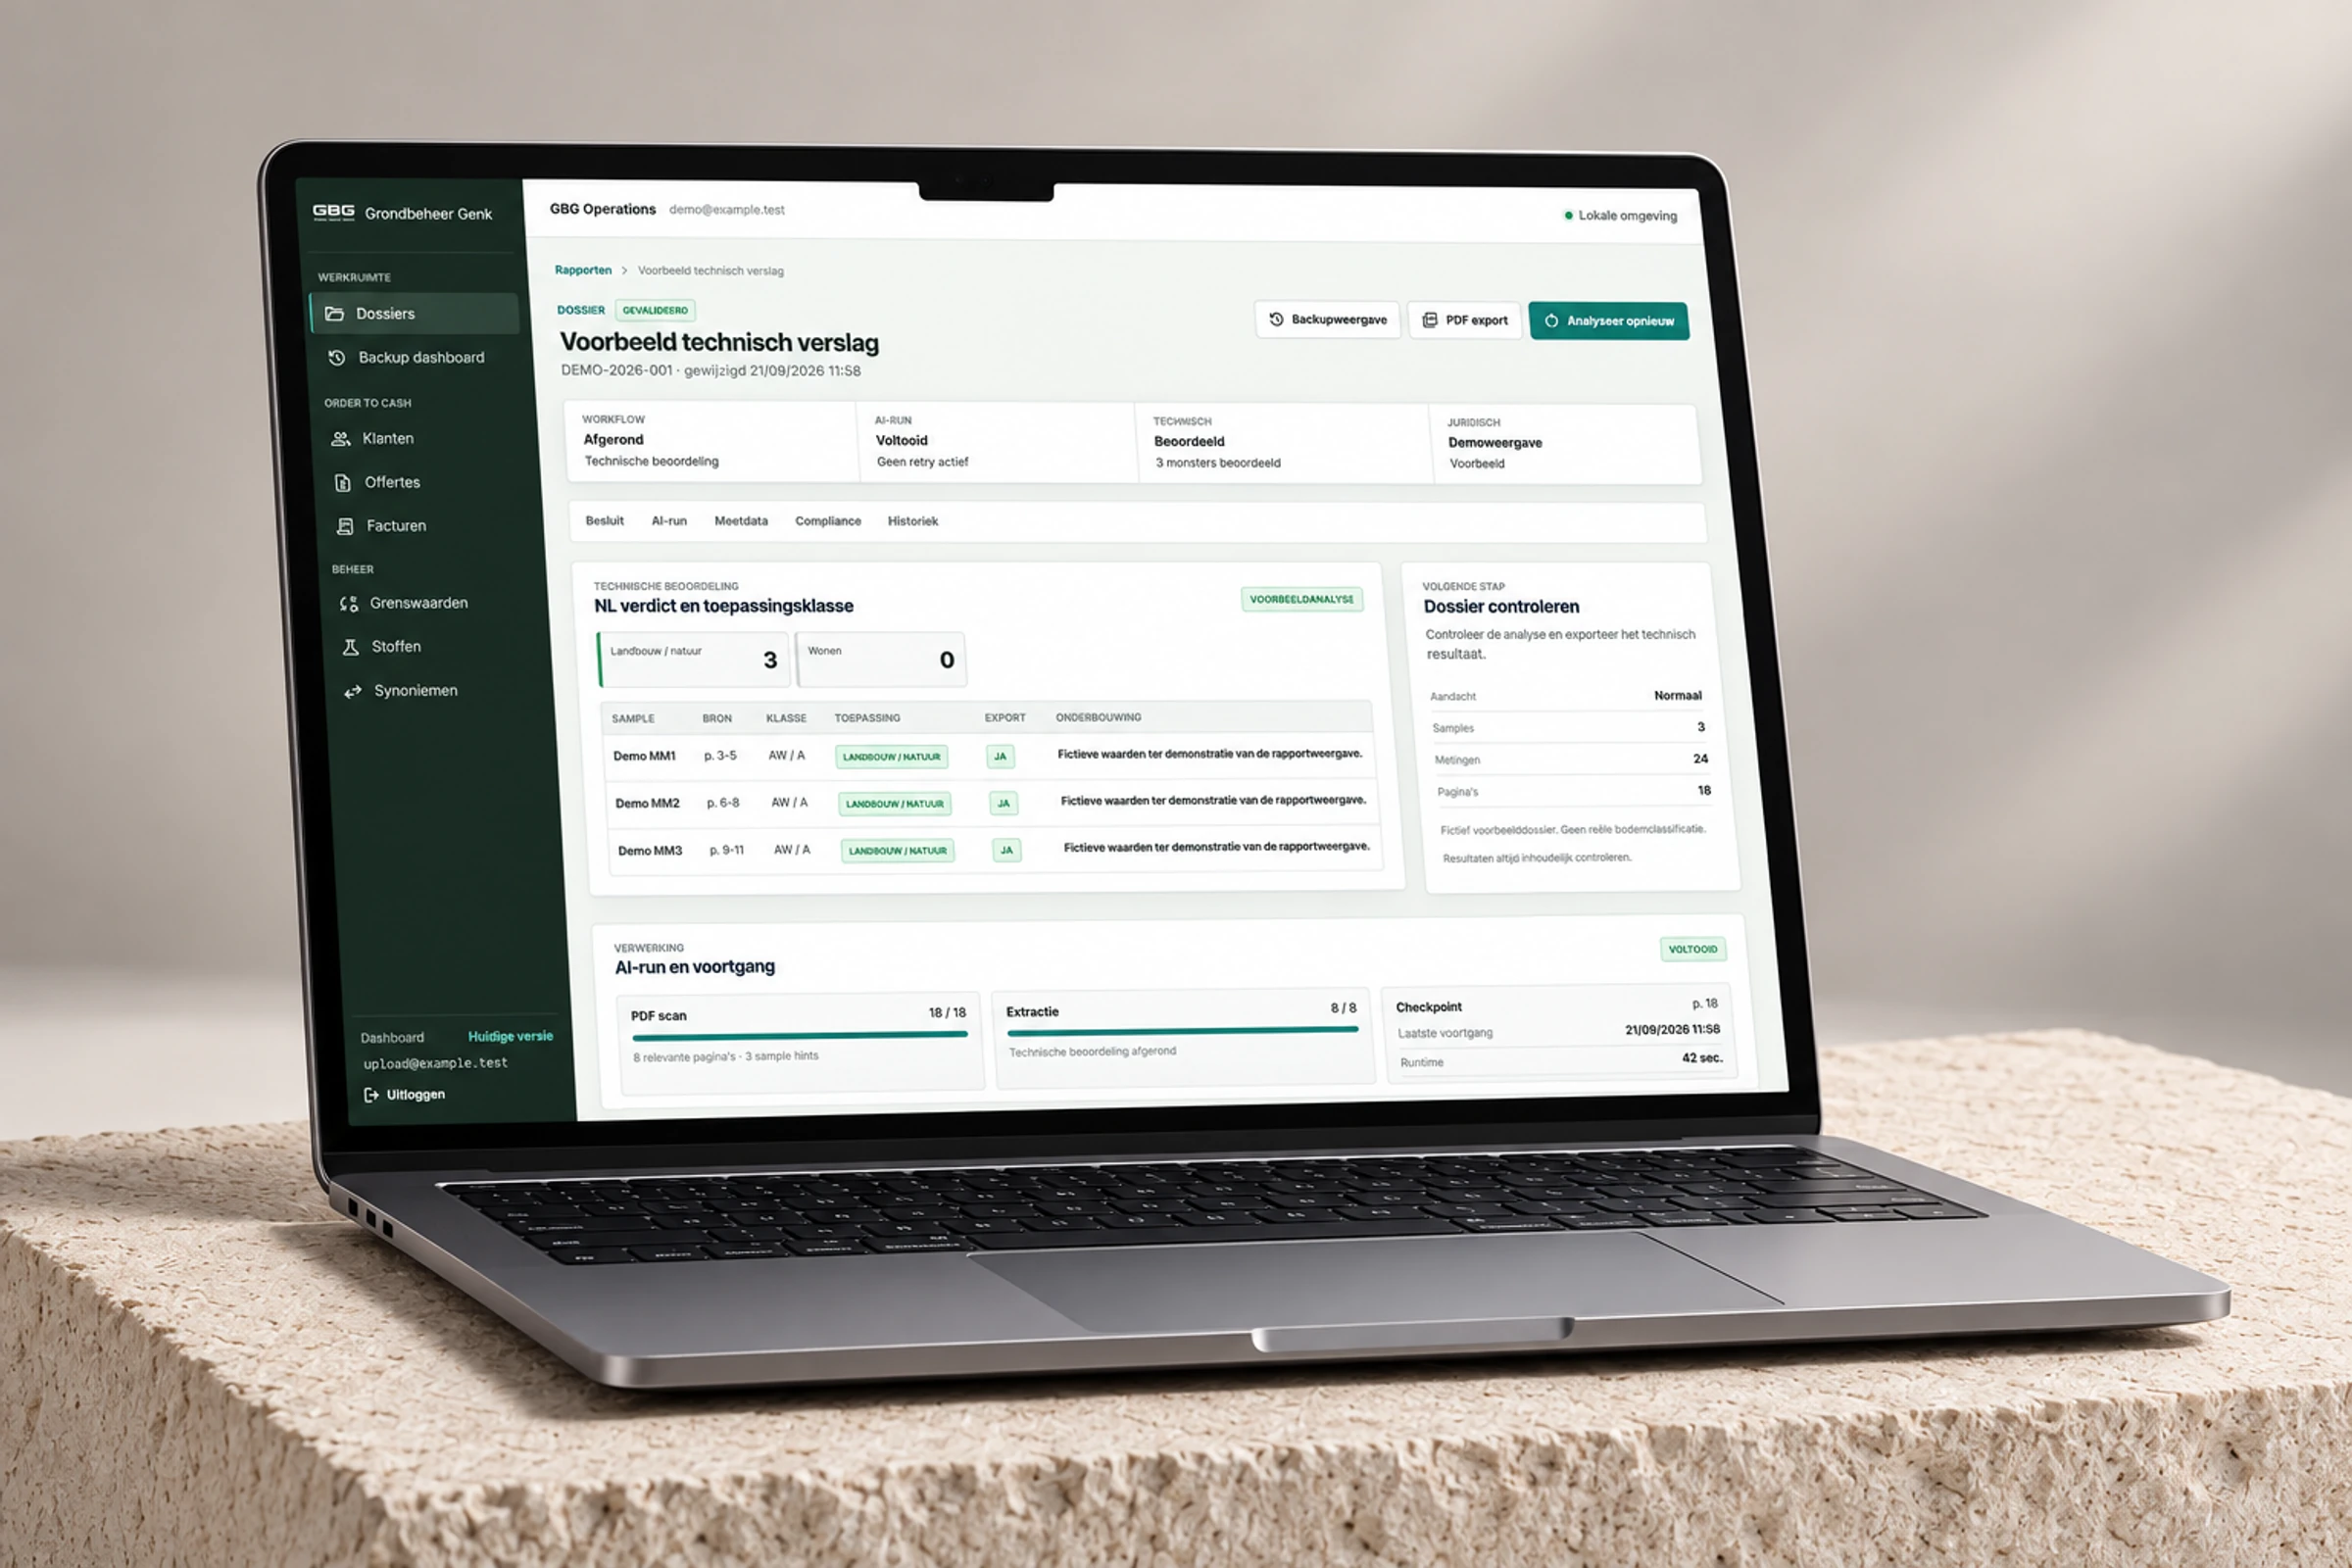
De uitgelezen gegevens worden gecontroleerd op structuur voordat ze worden opgeslagen. Stofnamen en synoniemen worden gekoppeld aan de centrale gegevensstructuur. Vervolgens voeren vaste rekenregels de normalisatie en classificatie uit, onder meer met referentiewaarden zoals lutum en organische stof.
De berekeningen uit de oorspronkelijke Excel-werkwijze zijn vastgelegd in regressietests. Daardoor kunnen wijzigingen worden gecontroleerd op afwijkingen in de uitkomsten. De classificatie steunt op expliciete regels en ingestelde grenswaarden.
Controle blijft onderdeel van het dossier
Het dashboard toont de voortgang, de resultaten en onderdelen die aandacht vragen. Ontbrekende referentiewaarden of onvolledige verwerking worden zichtbaar gemaakt voor verdere controle. Een onderbroken verwerking kan waar mogelijk vanaf een opgeslagen voortgangspunt worden hervat.
Medewerkers kunnen de resultaten beoordelen en een rapport met beslissingen en technische onderbouwing exporteren. Zo blijft duidelijk welke informatie aan de beoordeling ten grondslag ligt.